초안 모델로 생성 속도를 높이는 추측 디코딩
Google Research의 추측 디코딩은 작은 초안 모델이 제안한 토큰을 큰 모델이 한 번에 검증하고 확률적 수락 규칙으로 출력 분포를 그대로 유지해, T5-XXL의 생성 속도를 재학습 없이 2배에서 3배 높였습니다. M3 Pro 맥북의 Gemma 4 12B 단일 사용자 실측에서는 초안을 켜면 같은 출력을 유지한 채 생성 속도가 15.3 tok/s에서 33.4 tok/s로 2.18배 올랐습니다.
Google Research의 Leviathan, Kalman, Matias가 ICML 2023에서 발표한 추측 디코딩(speculative decoding)은 작은 초안 모델이 토큰 여러 개를 먼저 제안하고 큰 모델이 이를 한 번에 검증하는 방식으로, 출력 분포를 바꾸지 않고 T5-XXL의 생성 속도를 2배에서 3배 높였습니다. 재학습이나 구조 변경이 필요 없어 온프레미스와 노트북 환경의 단일 사용자 추론에 바로 적용할 수 있는 기법입니다.
핵심 요약
- 큰 모델(타깃 모델)의 디코딩은 연산보다 메모리 대역폭에 묶여 있어, 토큰 여러 개를 병렬로 검증해도 한 번 실행하는 시간과 크게 다르지 않습니다(논문 1장).
- 수락과 거절을 확률적으로 정하는 추측 샘플링 덕분에 출력 분포는 타깃 모델 단독 실행과 같습니다(2.3절, 부록 A.1).
- 속도 향상은 수락률 α, 초안 길이 γ, 초안 모델의 상대 비용 c 세 값으로 계산됩니다(정리 3.8). M3 Pro 맥북에서 Gemma 4 12B로 측정한 결과 초안을 끈 상태 대비 생성 속도가 2.18배였고 출력 텍스트는 글자 단위로 같았습니다.
문제 배경
자기회귀 모델은 토큰 K개를 만들 때 모델을 K번 순차 실행합니다. 논문은 이 순차 실행의 병목이 산술 연산보다 메모리 대역폭과 통신에 있다고 지적합니다(1장). 토큰 하나를 만들 때마다 가중치와 KV 캐시 전체를 메모리에서 읽어야 하므로, 연산 장치는 남는 상태로 대기하는 시간이 깁니다.
기존 가속 기법인 증류, 희소화, 양자화, 조기 종료는 대부분 모델 구조나 학습 절차를 바꾸고 출력도 원래 모델과 달라집니다(5장). 저자들은 남는 연산 자원을 동시 실행에 쓰고, 출력은 그대로 유지하는 방향을 택했습니다.
방법
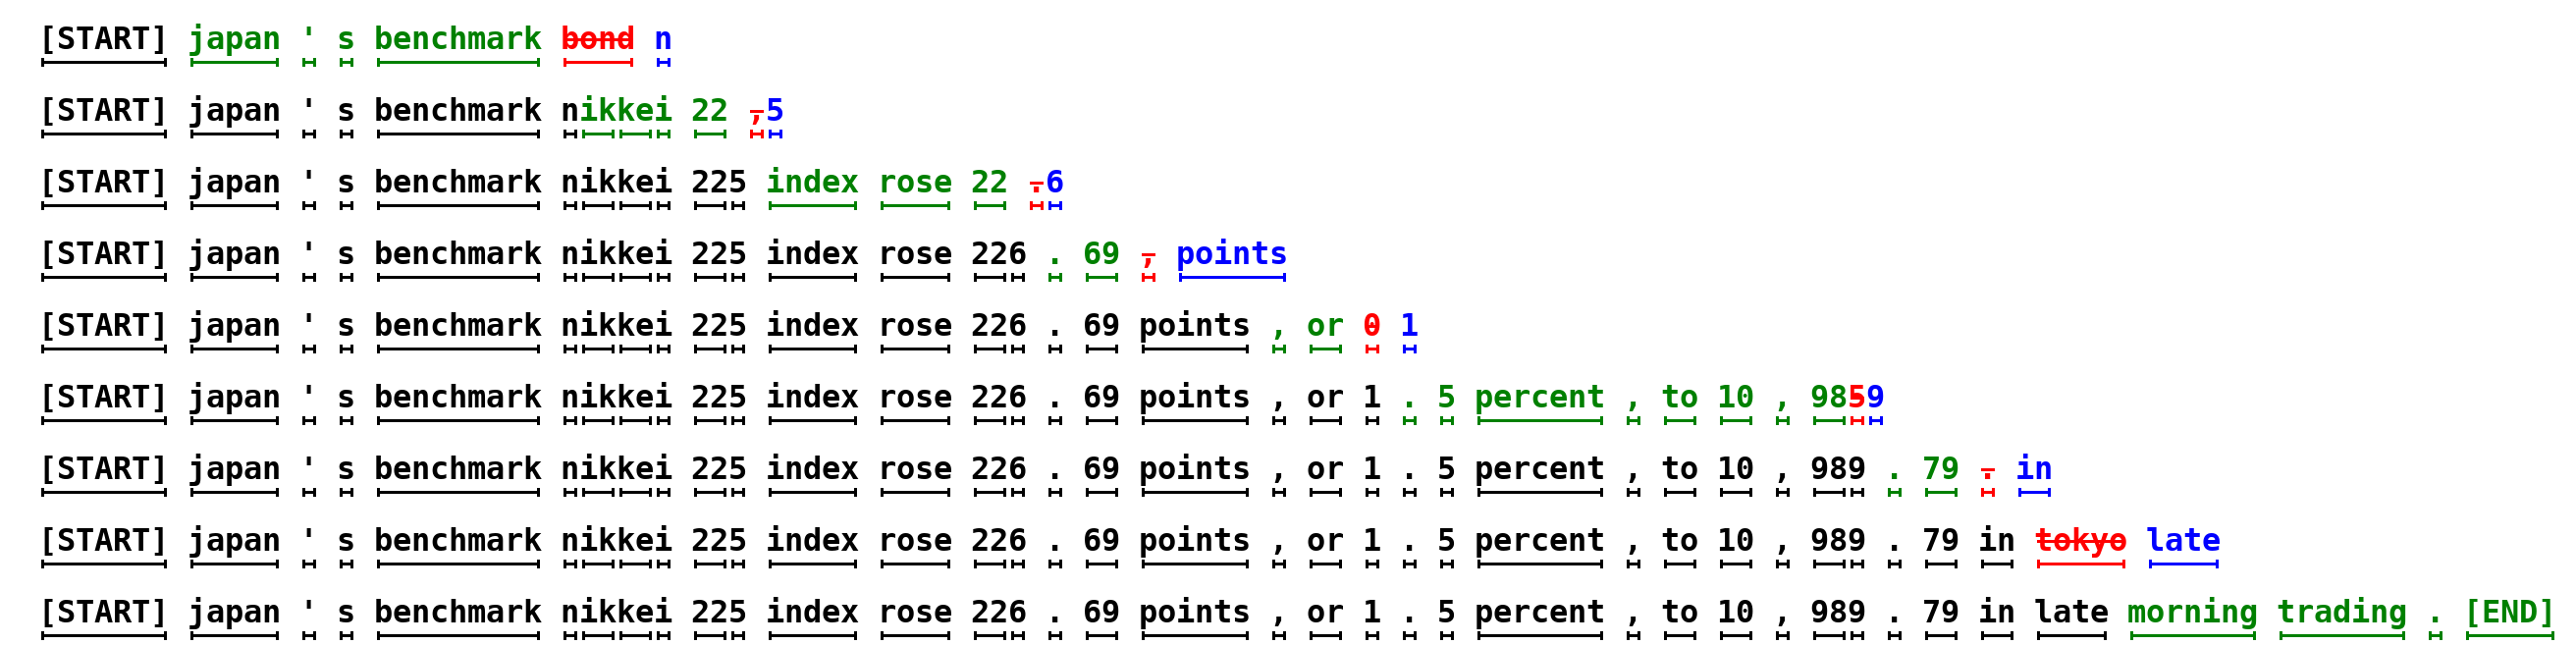
알고리즘 1의 한 단계는 세 부분으로 구성됩니다(2.1절).
- 초안 모델 Mq가 γ개 토큰을 순차적으로 생성합니다.
- 타깃 모델 Mp가 원래 접두사와 초안을 이어 붙인 γ+1개 위치를 한 번에 병렬로 평가합니다.
- 앞에서부터 초안 토큰을 검증합니다. 초안 확률 q(x)가 타깃 확률 p(x) 이하이면 그대로 수락하고, q(x)가 더 크면 1 − p(x)/q(x) 확률로 거절합니다. 거절된 위치에서는 max(0, p(x) − q(x))를 정규화한 분포에서 토큰을 다시 뽑고, 전부 수락되면 토큰 하나를 추가로 뽑습니다.
이 규칙으로 얻은 토큰은 어떤 p와 q에 대해서도 p를 따른다는 것이 부록 A.1의 증명입니다. 온도 0(argmax)에서는 초안 토큰이 타깃 모델의 최댓값 토큰과 같을 때만 수락되므로 출력이 완전히 일치합니다. 한 단계마다 타깃 모델은 최소 1개, 최대 γ+1개 토큰을 확정하므로 최악의 경우에도 타깃 모델 실행 횟수가 일반 디코딩보다 늘지 않습니다.
Figure 1의 문장은 38개 토큰으로 구성되며, 97M 타깃 모델을 9번만 실행해 생성됐습니다. 초안은 6M 모델입니다(1장).
같은 시기 DeepMind의 Chen 등(arXiv 2302.01318)도 수정된 거절 샘플링으로 같은 원리를 제안했고, Chinchilla 70B의 분산 환경에서 2배에서 2.5배 속도 향상을 보고했습니다. 이후 Medusa(arXiv 2401.10774)는 별도 초안 모델 대신 추가 디코딩 헤드와 트리 어텐션을 쓰는 방향으로 발전했습니다. 피처 수준에서 초안을 만드는 EAGLE은 EAGLE 추측 디코딩 인사이트에서 다룹니다.
수락률 α와 기대 속도 향상
수락률 α는 초안 토큰이 수락될 확률의 기댓값이며, 두 분포의 겹치는 부분인 Σ min(p(x), q(x))의 기댓값과 같습니다(정리 3.5, 따름정리 3.6). 수락 여부가 독립이라고 가정하면 한 단계에서 얻는 토큰 수의 기댓값과 실행 시간 기준 속도 향상은 다음과 같습니다(식 1, 정리 3.8).
E[토큰 수] = (1 - α^(γ+1)) / (1 - α)
속도 향상  = (1 - α^(γ+1)) / ((1 - α)(γc + 1))
c는 초안 모델 1회 실행 시간을 타깃 모델 1회 실행 시간으로 나눈 값입니다. 논문 실험에서 c는 항상 0.05 미만이었습니다(3.3절). α가 c보다 크면 이득이 나는 γ가 반드시 존재합니다(따름정리 3.9). 대가로 총 연산량은 늘어납니다. α = 0.8, γ = 5에서 연산량은 1.63배, 속도는 3.69배입니다(표 1, c = 0 가정).
표 2는 T5-XXL(11B)을 TPU v4 한 장, 배치 크기 1로 측정한 결과 중 일부입니다.
| 작업 | 초안 모델 | 온도 | γ | α | 속도 |
|---|---|---|---|---|---|
| 영독 번역 | T5-small (77M) | 0 | 7 | 0.75 | 3.4배 |
| 영독 번역 | T5-small (77M) | 1 | 7 | 0.62 | 2.6배 |
| 영독 번역 | T5-large (800M) | 0 | 7 | 0.82 | 1.7배 |
| 요약 | T5-small (77M) | 0 | 5 | 0.65 | 3.1배 |
| 요약 | T5-small (77M) | 1 | 5 | 0.53 | 2.3배 |
초안 모델이 클수록 α는 오르지만 c도 커져 T5-large가 가장 느렸습니다. 타깃보다 두 자릿수 정도 작은 초안 모델이 α와 c의 균형이 가장 좋았고(3.6절), 이런 조합의 α는 0.5에서 0.9 사이였습니다(4.2절). T5-XXL의 모든 조합에서 온도 1의 α가 온도 0보다 낮았고, 저자들은 조정된 분포가 뾰족할수록 α가 높다고 정리했습니다(표 2, 4.2절).
맥북 실측: Gemma 4 12B
M3 Pro(18GB) 맥북의 Ollama 0.40.6에서 gemma4:12b(11.9B, Q4_K_M)를 측정했습니다. 이 모델의 모델 파일에는 465MB 크기의 초안 가중치(DRAFT)와 draft_num_predict 3(γ = 3)이 기본으로 들어 있고, 서버 로그는 이 초안을 draft-mtp로 표기합니다. 초안을 끈 기준값은 요청 옵션 draft_num_predict: 0으로 얻었고, 이때 로그에 초안 통계가 남지 않는 것을 확인했습니다.
조건은 같은 한국어 프롬프트(입력 1,660토큰), 출력 300토큰, think: false, 온도 0, seed 1입니다. 설정마다 모델을 내린 뒤 첫 실행(로드 포함)을 따로 기록했고, 이후 실행은 프롬프트 캐시가 적용됐습니다(캐시 1,659토큰).
| 설정 | 첫 실행 생성 속도 | 이후 실행 생성 속도 | 이후 실행 총 시간 | 로그 수락률 | 기준 대비 |
|---|---|---|---|---|---|
| 초안 끔 | 15.53 tok/s | 15.12 / 15.36 / 15.41 | 약 19.9초 | 없음 | 1.00배 |
| γ = 1 | 19.91 tok/s | 20.77 (1회) | 14.8초 | 0.954 | 1.36배 |
| γ = 2 | 26.46 tok/s | 25.75 (1회) | 12.0초 | 0.919 | 1.68배 |
| γ = 3 (기본값) | 33.70 tok/s | 34.02 / 33.22 / 32.91 | 약 9.3초 | 0.901 | 2.18배 |
| γ = 5 | 41.12 tok/s | 41.67 (1회) | 7.5초 | 0.828 | 2.72배 |
측정 결과는 다음과 같습니다.
gemma4:12b에서 초안을 켠 γ = 1, 2, 3, 5 네 설정의 출력 텍스트가 초안을 끈 출력과 글자 단위로 같았습니다(md5 일치). 온도 0에서의 일치 보장이 실제로 확인됩니다.- 로그의 위치별 수락률은 γ = 3에서 0.951, 0.889, 0.852로 뒤로 갈수록 낮아졌습니다. 논문의 독립 가정과 다른 부분입니다.
- 로그 수락률을 식 1에 넣고 c = 0으로 계산한 상한은 γ = 3에서 3.44배인데 실측은 2.18배였습니다. c = 0 가정과 달리 초안 실행과 검증에도 시간이 들기 때문으로 보입니다.
- 첫 실행의 프롬프트 처리는 초안 유무와 관계없이 10.0초에서 10.7초였습니다. 추측 디코딩은 생성 단계만 줄이므로 입력이 길고 출력이 짧은 요청에서는 체감 효과가 작습니다.
- 같은 가중치에
num_ctx 16384만 다른gemma4-wiki도 같은 초안을 쓰며, 이후 실행 생성 속도는 33.89 / 34.44 / 34.27 tok/s로 기본 모델과 차이가 없었습니다. 입력 토큰 수가 1,656개로 4개 적었고, 출력은 기본 모델 출력의 앞부분과 같은 텍스트였습니다.
한계와 적용 조건
논문은 추측 디코딩이 연산량을 늘려 지연을 줄이는 방식이므로 추가 연산 자원이 없는 구성에서는 도움이 되지 않는다고 명시합니다(6장). 동시 요청을 크게 묶어 처리하는 서빙 서버는 이미 연산 장치가 포화 상태에 가까워 이득이 줄어듭니다. 반대로 사용자 한 명이 노트북이나 사내 서버 한 대에서 모델을 실행하는 경우는 메모리 대역폭이 병목이라 논문의 전제와 맞습니다.
초안 모델과 타깃 모델이 다르게 학습됐다면 α가 낮아집니다. 바이그램 모델의 α는 0.20, 속도 향상은 1.25배에 그쳤습니다(3.6절, 표 3). 검증 규칙은 같은 토큰에 대한 p(x)와 q(x)를 비교하므로 두 모델의 어휘(토크나이저)가 같아야 합니다. 논문도 같은 구조와 같은 확률 표준화를 쓰는 조합만 실험했습니다(3.6절). 빔 서치와의 호환은 후속 과제로 남겨 두었습니다(6장).
도입 검토 가이드
| 구분 | 내용 |
|---|---|
| 우선 검토 대상 | 단일 사용자 또는 낮은 동시성으로 실행하는 온프레미스 sLLM, 노트북 로컬 모델 |
| 전제 조건 | 타깃 모델과 토크나이저가 같은 초안 모델 또는 초안 모듈 확보 |
| 측정 항목 | 초안 끔과 켬의 생성 속도, 런타임 로그의 수락률, 프롬프트 처리 시간 비중 |
| 판단 기준 | γ를 1부터 늘리며 생성 속도가 가장 높은 값을 선택하고, 온도를 실제 운영값으로 맞춰 다시 측정 |
적용 절차는 런타임이 초안 통계를 기록하는지 먼저 확인하고, 같은 프롬프트로 초안을 끈 기준값을 측정한 뒤 γ를 바꿔 가며 비교하는 순서가 기본입니다. 이미 초안이 기본으로 켜진 모델 배포판도 있으므로, 기준값을 측정하기 전에 모델 파일의 초안 설정을 확인해야 합니다.
코텍시스 AI사업부는 sLLM 최적화, Advanced RAG, AI Agent 개발을 수행합니다. 이런 기법의 도입을 검토 중이라면 문의를 남겨주세요.
이 기술을 도입하려면: sLLM & SLM Optimization
AI 개발 문의기술 블로그 최신 글
회사 자료를 노트북 밖으로 안 내보내는 팀 AI 위키 (로컬 LLM · 옵시디언 · Ollama)
Ollama와 옵시디언, Karpathy LLM Wiki 플러그인으로 회의록 15건을 노트북 안에서 위키 42쪽으로 정리한 구성과 설정을 기록합니다. M3 Pro 18GB에서 걸린 2시간 38분과 작은 모델이 틀린 숫자, 점검 절차를 함께 정리합니다.
AI가 찾아낸 브라우저·OS 취약점과 기업의 대응 기준
Anthropic이 내부 연구용 모델로 Chrome, Safari, Android, Windows, Linux에서 다섯 개의 실제 공격 체인을 완성한 기록을 공개했습니다. 발견 방식과 방어자 지원 프로그램을 정리하고 우리나라 기업이 보안 운영에서 확인할 기준을 짚었습니다.
전문가가 AI 에이전트에 판단을 넘기는 지점
Anthropic이 인과추론 전문가 50명에게 Claude Code로 분석을 맡긴 실험에서 분석가는 에이전트의 무작위 선호를 86% 따랐습니다. 그러면서도 절반 이상이 최종 권고를 자기 판단이라고 답했습니다.
같은 주제의 다른 인사이트
토큰당 KV 캐시 크기로 계산하는 온프레미스 동시 처리량
vLLM 논문이 보인 것처럼 LLM 서빙의 동시 처리량은 GPU 메모리에서 가중치를 빼고 남은 공간을 토큰당 KV 캐시 크기로 나눈 값이 정합니다. Qwen3-8B와 Qwen3-32B의 config.json으로 계산하면 80GiB GPU 1장에서 8,192토큰 세션 상한이 57개와 9개로, 가중치 크기 차이 4배보다 큰 6배 이상의 차이가 납니다.
SGLang: 구조화된 LLM 프로그램을 위한 서빙 시스템
SGLang은 다중 호출과 제어 흐름이 얽힌 LLM 프로그램을 위한 언어와 런타임을 함께 설계해 RadixAttention 기반 KV 캐시 재사용으로 기존 시스템 대비 최대 6.4배의 처리량을 달성했습니다. 에이전트 워크플로와 JSON 구조화 출력이 많은 기업 자동화 파이프라인일수록 이 캐시 재사용 효과가 비용 절감으로 직결됩니다.
토큰이 아니라 피처를 예측하는 EAGLE 추측 디코딩
EAGLE은 추측 디코딩의 초안 생성을 토큰 수준이 아닌 모델 내부 피처 수준에서 수행해 LLaMA2-Chat 70B 기준 2.7배에서 3.5배의 지연 시간 단축과 2배의 처리량 향상을 생성 분포 변화 없이 달성했습니다. 별도의 소형 초안 모델을 구하기 어려운 사내 특화 sLLM에도 가벼운 예측 헤드 하나로 적용할 수 있다는 점이 실무적 강점입니다.